CPU, GPU y aceleradores organizan el paralelismo de maneras distintas. El procesador se elige por forma y límite. El pico es un techo.
CPU y GPU intercambian flexibilidad por amplitud
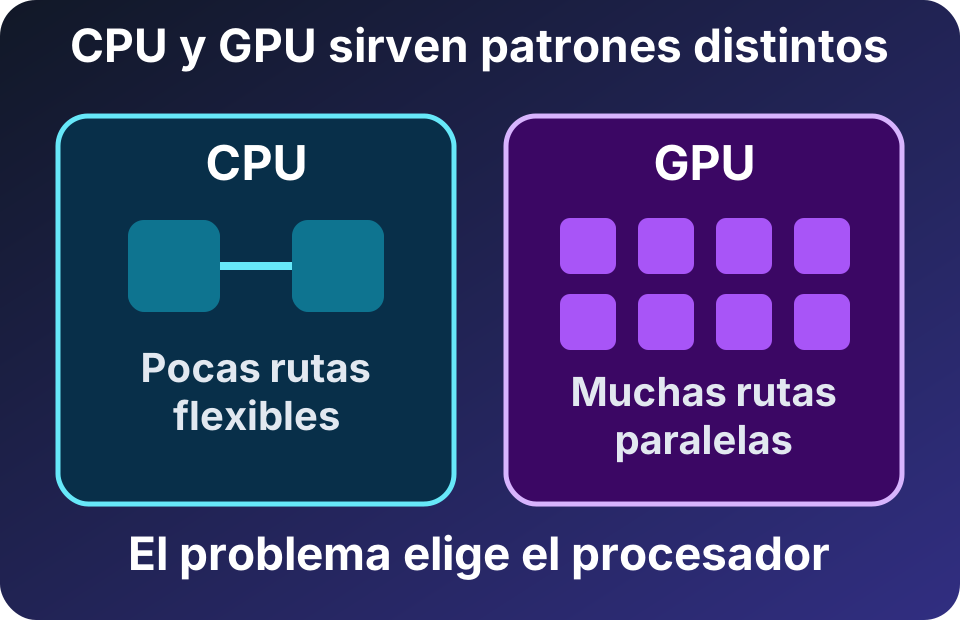
Diagrama propio del curso, SVG accesible, 2026.
Lectura textual del diagrama: la CPU dedica más recursos a pocos flujos con decisiones y baja latencia. La GPU reúne muchas unidades para aplicar operaciones parecidas a numerosos datos. Ninguna forma sirve para todo problema.
Una CPU favorece control irregular, trabajo secuencial y solicitudes pequeñas. Una GPU favorece throughput si hay trabajo independiente. Ramas o accesos divergentes dejan unidades esperando; lanzar kernels, copiar y sincronizar también cuesta. A menudo la CPU coordina y la GPU procesa lotes, por lo que se mide el flujo completo.
FACT (objeto fotografiado): Palit RTX 5090 GameRock. Foto de PantheraLeo1359531, Wikimedia Commons, CC BY 4.0; redimensionada a WebP.

FACT (especificación NVIDIA de referencia): la RTX 5090 publica 575 W TGP para la tarjeta, no para el equipo. El diseño Palit fotografiado puede variar.
Los aceleradores especializan el trabajo
Un acelerador optimiza hardware para un dominio, con recursos propios, compartidos o unificados.
NPU es una etiqueta industrial para operadores neuronales, no una arquitectura única. Un operador no soportado puede volver a CPU o GPU.
TPU nombra una familia de ASIC de Google, no una categoría genérica. FACT (pico, no benchmark): cada TPU7x Ironwood publica 2,307 TFLOPS BF16, 4,614 TFLOPS FP8, 192 GiB HBM y 7,380 GB/s HBM. La precisión cambia tasa, memoria, tráfico y comportamiento numérico; los picos no forman un ranking entre precisiones o sistemas.
Especializar intercambia flexibilidad por eficiencia; importan operadores, compilador, memoria, lote, transferencias y disponibilidad.
FLOP es trabajo; FLOPS es tasa
Un FLOP es una operación de punto flotante. FLOPS significa operaciones de punto flotante por segundo. FACT (convención SI decimal): GFLOPS, TFLOPS y PFLOPS multiplican esa tasa por $10^9$, $10^{12}$ y $10^{15}$. Un total de FLOP describe trabajo; FLOPS describe ritmo.
La precisión es parte de la unidad de comparación:
- FP64 conserva más precisión para ciertos cálculos científicos.
- FP32 ofrece precisión y soporte general.
- FP16 y BF16 reducen bytes y aprovechan unidades matriciales.
- FP8 e INT8 reducen más tráfico, con técnicas numéricas apropiadas.
Menos bits no garantiza calidad. Un pico sparse supone ceros aprovechables y no equivale al pico dense. TOPS enteros y FLOPS flotantes tampoco son intercambiables.
Roofline conecta cómputo y memoria
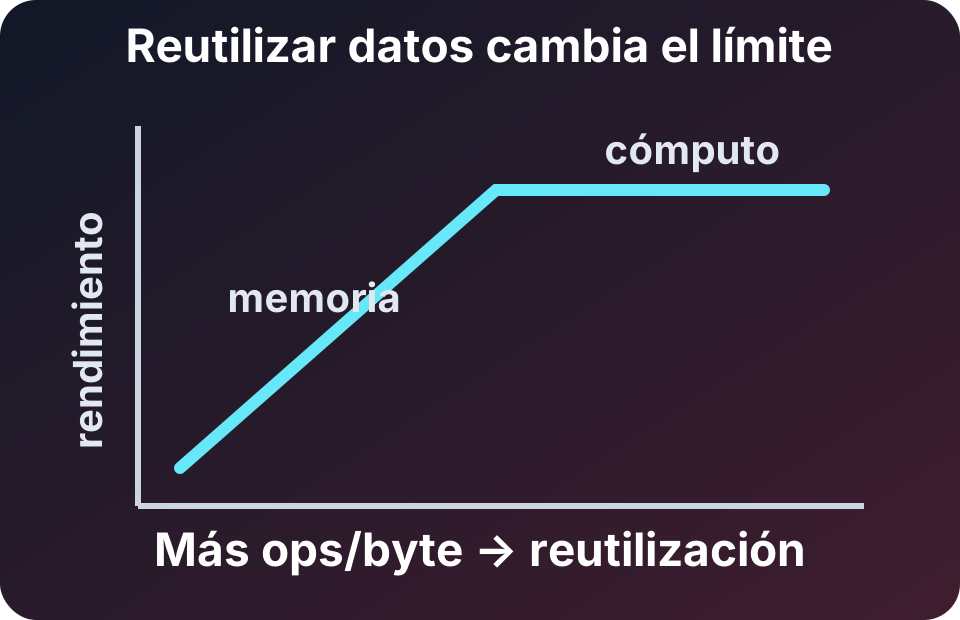
Diagrama propio del curso, SVG accesible, 2026.
Lectura textual del diagrama: el eje horizontal representa operaciones por byte y el vertical, rendimiento. Con poca reutilización manda el ancho de banda; con mucha se alcanza el techo de cómputo. La ejecución real queda debajo de ambos.
La intensidad aritmética es trabajo dividido entre tráfico de memoria:
$$I = \frac{\text{FLOP}}{\text{bytes movidos}}$$
El modelo Roofline-lite expresa un límite:
$$P \leq \min(P_{pico},\ B_{memoria}\times I)$$
DERIVED (modelo simplificado): sumar dos vectores FP32 para producir un tercero mueve al menos 12 bytes por elemento, dos lecturas y una escritura, y realiza 1 FLOP. Su intensidad es aproximadamente 0.083 FLOP/byte, sin contar tráfico adicional. Reutilizar bloques de una multiplicación de matrices puede elevar mucho la intensidad.
En la pendiente conviene mover menos bytes, mejorar localidad o ancho de banda. En la meseta conviene usar mejor las unidades, aumentar paralelismo o elegir otra precisión compatible.
Roofline no predice una solicitud pequeña: latencia, arranque, dependencias, ramas y sincronización pueden alejarla del techo. Ancho de banda es volumen por tiempo; latencia es espera. Ambos se miden.
Pico, benchmark y aplicación son capas distintas
El pico teórico combina unidades, operaciones por ciclo y frecuencia bajo supuestos de precisión, instrucciones y densidad. Puede omitir entrada, copias y coordinación.
En MLPerf, una comparación válida usa el mismo benchmark: la misma tarea o modelo, el mismo dataset y el mismo objetivo de calidad. También alinea escenario, métrica y división; la división Closed exige el modelo de referencia, mientras Open permite cambios que deben interpretarse como tales.
Precisión, lote, software y disponibilidad dan contexto. Cuando una entrega incluye potencia, MLPerf mide el sistema completo mediante AC en la pared durante ese benchmark; TDP y potencia nominal de la fuente no equivalen.
La aplicación observada incluye el pipeline; sus métricas deben compartir contexto.
Potencia y energía responden cosas distintas
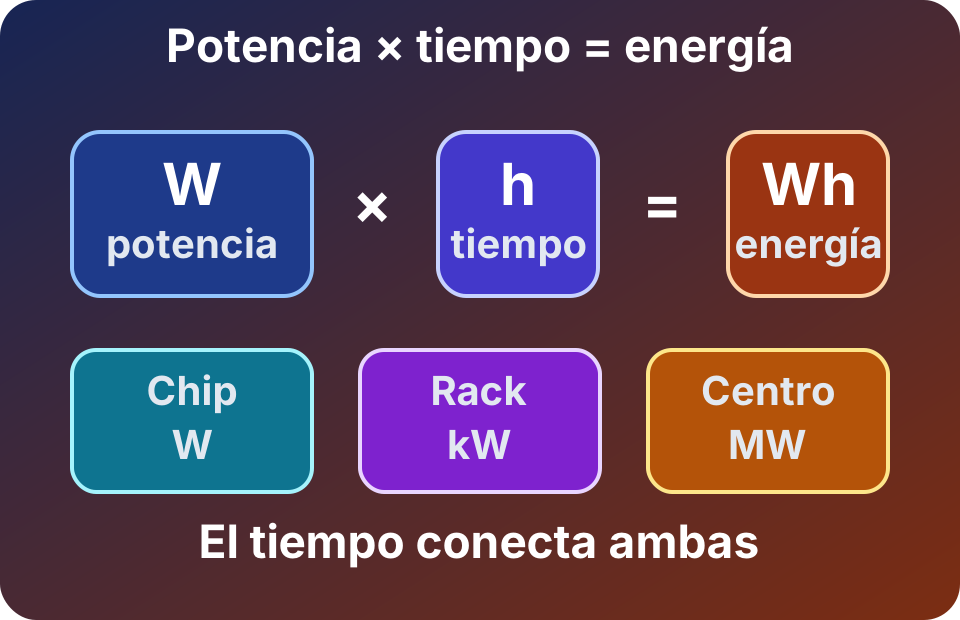
Diagrama propio del curso, SVG accesible, 2026.
Lectura textual del diagrama: watts por horas producen watt-hora. Un dispositivo suele expresarse en W, un rack en kW, un centro de datos en MW y la generación agregada puede llegar a GW. Al integrar tiempo aparecen Wh, kWh, MWh, GWh o TWh.
El watt mide potencia, una tasa instantánea. El watt-hora mide energía acumulada. FACT (convención SI decimal): $1\ \mathrm{kW}=10^3\ \mathrm{W}$, $1\ \mathrm{MW}=10^6\ \mathrm{W}$ y $1\ \mathrm{GW}=10^9\ \mathrm{W}$. Mantener 1 kW durante una hora consume 1 kWh.
TGP referencia una tarjeta; TDP guía diseño térmico y varía por fabricante. La potencia AC en la pared añade componentes y pérdidas. No son equivalentes.
DERIVED (escenario, no consumo medido): 575 W sostenidos durante una hora equivalen a 0.575 kWh para la tarjeta. El host y las pérdidas quedan fuera. La duración transforma una tasa en energía.
El power wall cambió la estrategia
FACT (síntesis histórica): durante décadas, reducir el tamaño de los transistores permitió elevar frecuencia sin aumentar igual la densidad de potencia. Al fallar ese escalamiento de voltaje, cerca de 2005, calor y potencia limitaron la frecuencia. La respuesta combinó multicore, SIMD, aceleradores y eficiencia.
El power wall cambió el progreso: más transistores no implican activarlos todos al máximo. Software, paralelismo y especialización deciden cuánto hardware resulta útil.
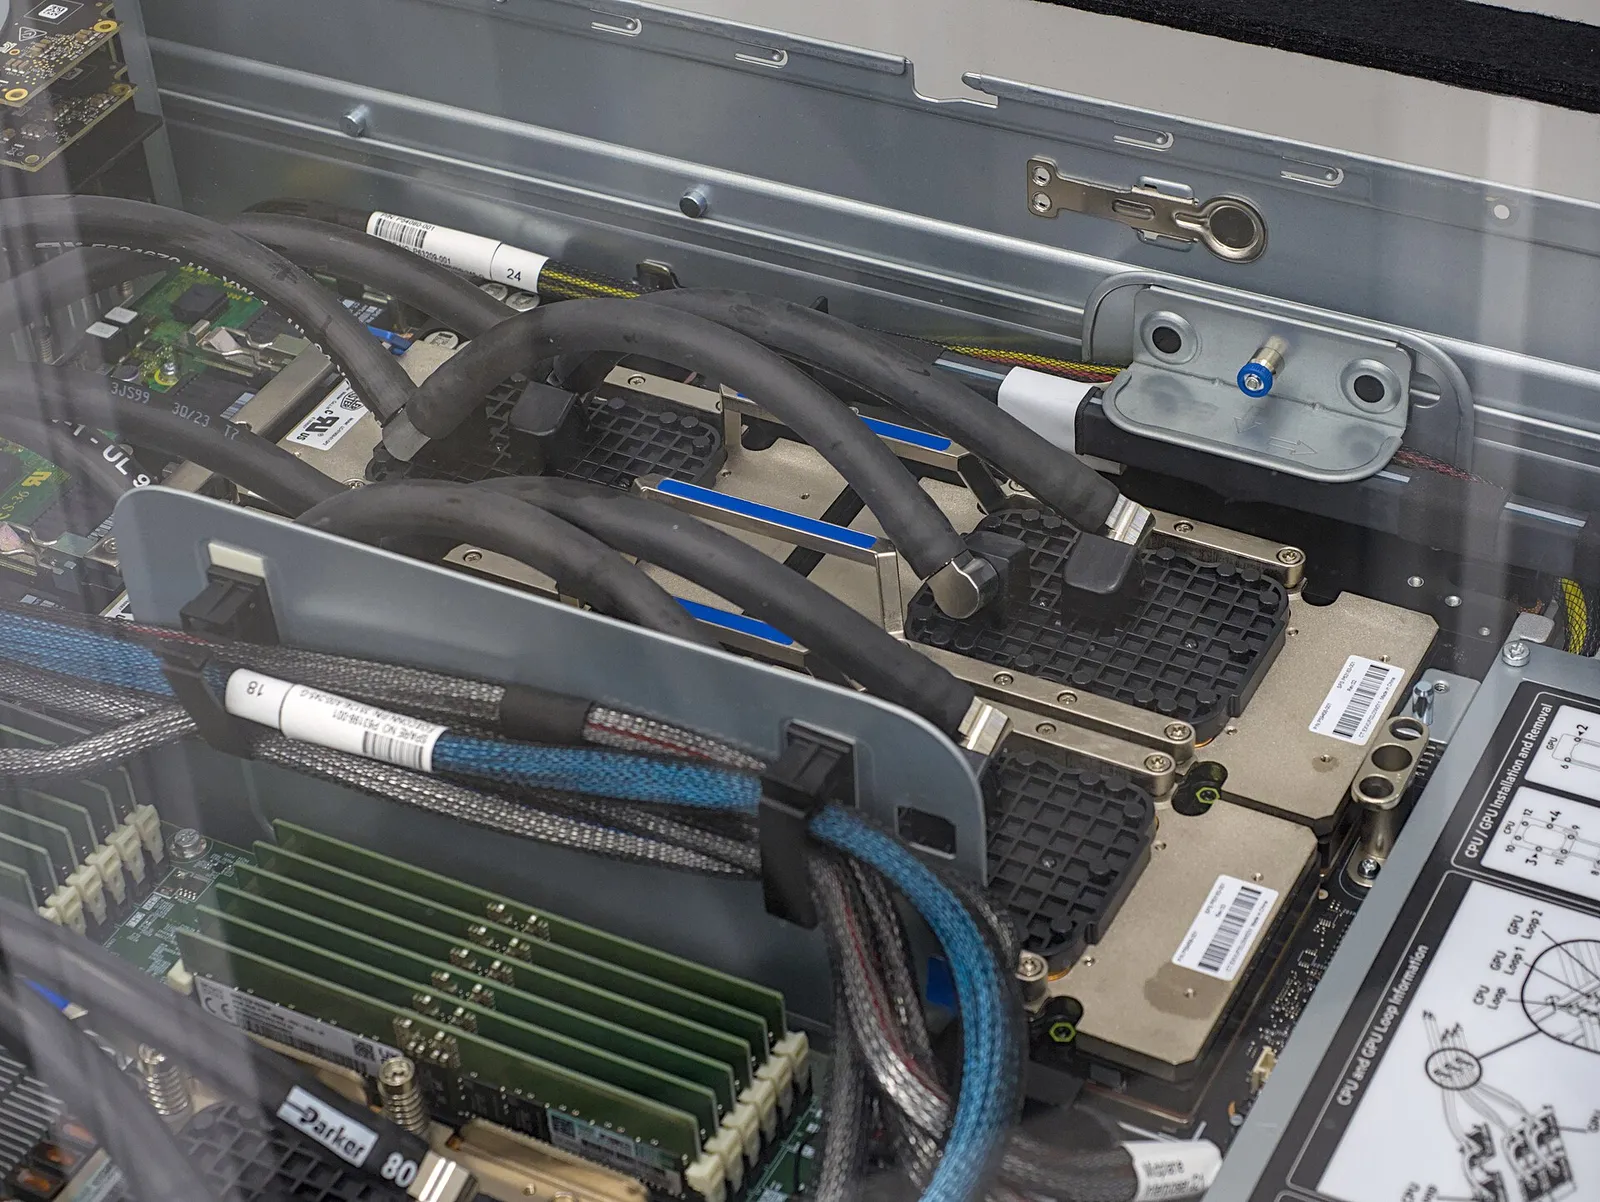
FACT (objeto fotografiado): nodo de TSUBAME 4.0 con cuatro GPU NVIDIA H100. La foto ilustra un nodo multi-GPU, no un sistema GB300 actual. Foto de Fukumoto en Wikimedia Commons, CC BY-SA 4.0; redimensionada y convertida a WebP para el curso.

Del dispositivo a la generación
La escala encadena dispositivo en W, rack en kW y centro de datos en MW. Cada nivel añade red, almacenamiento, enfriamiento, conversión y redundancia.
FACT (capacidad máxima, no consumo observado): NVIDIA documenta que un rack GB300 NVL72 integra 72 GPU y 36 CPU, usa refrigeración líquida y requiere hasta 142 kW. DERIVED (escenario de placa): 142 kW constantes durante 24 horas serían 3.408 MWh; durante 8,760 horas serían 1.244 GWh. El cálculo supone carga constante y excluye infraestructura exterior al rack.
En el nivel global se acumula energía, no sólo potencia. ESTIMATE (IEA 2026, proyección central): el consumo eléctrico de centros de datos pasa de 485 TWh en 2025 a alrededor de 950 TWh en 2030; dentro de esa proyección, el consumo de centros enfocados en IA se triplica. Son estimaciones con incertidumbre, no lecturas de medidor ni potencia instantánea.
Escalar amplifica movimiento, refrigeración y energía. Sigue IA, escala y selección de hardware.
Fuentes
- Berkeley Lab — Roofline Performance Model: intensidad, ancho de banda y techo de cómputo.
- NVIDIA — RTX Blackwell GPU Architecture: TGP, precisión y calificadores dense/sparse de la RTX 5090.
- Google Cloud — TPU7x Ironwood: picos por precisión y HBM oficiales.
- MLCommons — MLPerf Inference: Datacenter: escenarios, calidad y medición AC del sistema completo.
- BIPM — The International System of Units: watt, prefijos SI y relación entre potencia y energía.
- Microsoft Research — Dark silicon and the end of multicore scaling: escalamiento de Dennard y límite de potencia.
- NVIDIA — NVL72 AI Factory, System Hardware and Components: composición, refrigeración y potencia máxima del rack GB300 NVL72.
- IEA — Key Questions on Energy and AI, executive summary (2026): proyección central 2025–2030 para electricidad de centros de datos y centros enfocados en IA, CC BY 4.0.
- Wikimedia Commons — Palit GeForce RTX 5090 GameRock: fotografía de PantheraLeo1359531, CC BY 4.0.
- Wikimedia Commons — TSUBAME 4.0: fotografía de Fukumoto, CC BY-SA 4.0.