Un modelo de IA transforma entradas con parámetros. El hardware aloja y mueve su estado para cumplir latencia, throughput, energía y costo. Los parámetros inician el presupuesto, no lo completan.
Inferencia y entrenamiento ocupan memoria distinta
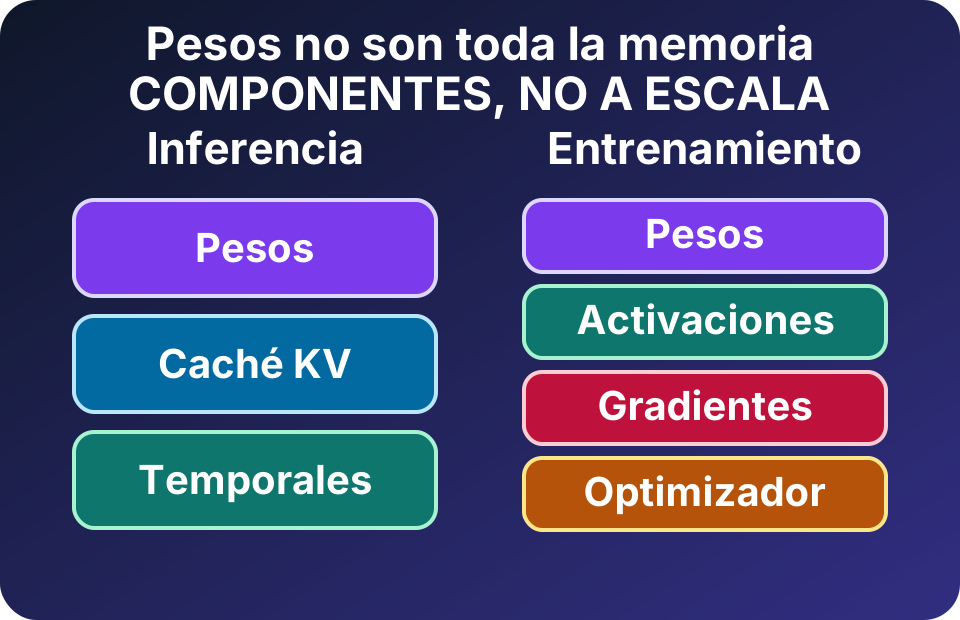
Diagrama propio del curso, SVG accesible, 2026. Los bloques nombran componentes; sus tamaños no están a escala.
Lectura textual del diagrama: inferencia necesita pesos, caché KV y temporales. Entrenamiento añade activaciones, gradientes y estados del optimizador. El runtime reserva otros buffers.
En inferencia, prefill procesa el prompt y decode produce tokens reutilizando la caché KV. Evita recalcular la historia, pero ocupa memoria.
Más contexto aumenta caché KV y atención; suele empeorar latencia y throughput por solicitud. El máximo admitido no indica cuántas peticiones caben.
El batching agrupa secuencias: puede elevar throughput, pero consume memoria y suma espera. Contexto y batch se ajustan por separado con solicitudes reales.
En entrenamiento, forward crea activaciones, backward gradientes y el optimizador actualiza parámetros. Recomputation cambia memoria por cálculo. Partir estados reduce memoria local, pero obliga a comunicarlos.
La cuenta mínima de los pesos
Para parámetros almacenados con precisión uniforme, sea $N_p$ su cantidad y $b$ sus bits. FACT (convención decimal): B representa $10^9$ y T representa $10^{12}$; GB y TB aquí también son decimales.
$$M_{pesos}=N_p\times\frac{b}{8}$$
DERIVED (GB decimales, sólo pesos):
- 7B: BF16 = $7\times10^9\times2$ bytes = 14 GB; INT8 = 7 GB; INT4 = 3.5 GB.
- 70B: BF16 = 140 GB; INT8 = 70 GB; INT4 = 35 GB.
- 1T: BF16 = 2 TB; INT8 = 1 TB; INT4 = 0.5 TB.
Son capacidades lógicas. GiB, escalas, padding, buffers y particionado cambian la memoria física.
DERIVED (presupuesto base de esta receta): mixed precision con Adam clásico suma ~18 bytes por parámetro: 2 de pesos BF16/FP16 + 4 de copia FP32 + 4 de gradiente FP32 + 8 de estados Adam FP32. Para 7B, 70B y 1T son 126 GB, 1.26 TB y 18 TB de estado agregado del modelo, antes de activaciones y temporales.
No obliga a guardar 18 bytes completos en cada GPU. El sharding reparte estado y reduce memoria local a cambio de comunicación y buffers. Precisión, activaciones, temporales e implementación cambian el máximo real.
Cuantizar cambia más que capacidad
Cuantizar pesos reduce bytes y tráfico, pero exige soporte y validación numérica; INT4 no duplica necesariamente la velocidad de INT8.
Cuantizar pesos no reduce automáticamente caché KV ni activaciones. Valida precisión, contexto, batch y calidad en el hardware real.
Distribuir crea una segunda carga
Distribuir añade una segunda carga:
- Paralelismo de datos: replica el modelo y divide batches. En entrenamiento, all-reduce combina y redistribuye gradientes; en inferencia, réplicas atienden solicitudes distintas.
- El paralelismo de modelo es el paraguas para dividir un modelo entre dispositivos. Sus formas incluyen tensor y pipeline.
- Paralelismo tensorial: parte tensores de cada capa; colectivas como all-reduce o all-gather exigen enlaces rápidos.
- Paralelismo de pipeline: reparte grupos de capas; envía activaciones y puede crear burbujas.
Bandwidth, latencia y topología determinan el resultado. Más dispositivos no prometen speedup lineal.
Del chip al centro de datos
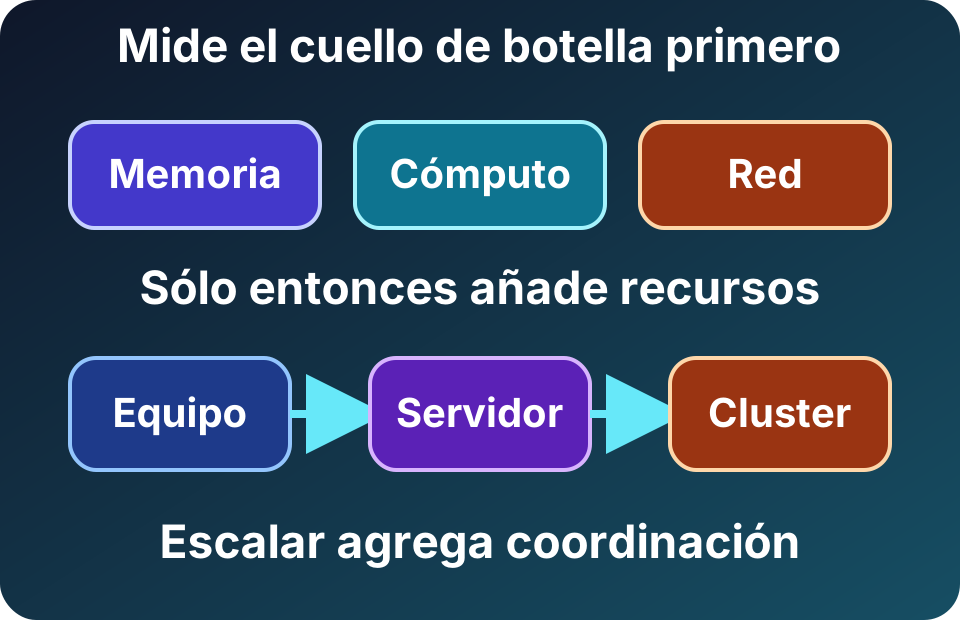
Diagrama propio del curso, SVG accesible, 2026.
Lectura textual del diagrama: primero se mide memoria, cómputo y comunicación; después se escala. Cada salto añade capacidad, coordinación, fallas y energía.
La cadena es chip → board → servidor → rack → cluster → centro de datos. Cada nivel añade memoria, red, potencia, refrigeración y operación.
Cuatro ejemplos representativos, no un ranking
- FACT (límite de producto): M5 Max admite hasta 128 GB unificados y 614 GB/s; no son benchmark ni TDP.
- FACT (referencia NVIDIA): RTX 5090 tiene 32 GB GDDR7, 1,792 GB/s de ancho de banda pico de memoria y 575 W TGP. Pesos, cachés y temporales comparten capacidad; tarjetas de ensambladores pueden variar.
- FACT (picos por chip): TPU7x ofrece 192 GiB HBM, 7,380 GB/s, 2,307 TFLOPS BF16 y 4,614 TFLOPS FP8; un pod llega a 9,216 chips. No es desempeño observado.
- FACT (sistema oficial, máximos agregados): DGX GB300 integra 72 GPU Blackwell Ultra, 36 CPU Grace, 20 TB de memoria GPU, hasta 576 TB/s HBM y 130 TB/s NVLink. El rack usa refrigeración líquida y admite hasta 142 kW; es capacidad máxima, no consumo medido.
No son un ranking: la aplicación y la medición completa deciden.
Guía de decisión
- Define la carga: inferencia o entrenamiento, precisión, contexto, concurrencia, latencia y volumen.
- Presupuesta memoria: pesos más caché KV o activaciones, gradientes, optimizador, temporales y margen del runtime.
- Mide: utilización, memoria máxima, bytes, latencia, throughput, potencia de pared y calidad.
- Ataca el límite: capacidad para OOM; localidad o bandwidth para datos; compute para unidades saturadas; interconexión para comunicación.
- Escala el tramo útil: batching, cuantización validada y cluster sólo cuando capacidad o servicio lo exige.
- Incluye operación: software, disponibilidad, confiabilidad, seguridad, costo total y energía.
Repaso conceptual
- ¿Cómo conserva compatibilidad una ISA entre microarquitecturas, y por qué reloj/ciclos/GHz no garantizan latencia/throughput de trabajo útil?
- ¿Qué mediciones distinguen un límite de latencia, ancho de banda o mala localidad, y cómo cambia el objetivo si importa throughput?
- ¿Qué forma de trabajo favorece una CPU y cuál una GPU, incluyendo el costo de mover y sincronizar datos?
- ¿Cómo usa Roofline la intensidad aritmética para separar un límite de memoria de uno de cómputo?
- ¿Por qué potencia en W y energía en Wh responden preguntas distintas al comparar dos ejecuciones?
- ¿Qué incluye un presupuesto de memoria de IA y qué medirías del all-reduce antes de escalar a un cluster?
Escenarios de decisión
Tres grupos pequeños resuelven un escenario cada uno en paralelo durante siete minutos: una sola ronda presencial.
Escenario 1 — Asistente local
Un 70B INT4 debe correr sin red. DERIVED: sus pesos ocupan 35 GB antes de caché KV y temporales. ¿Elegirías 32 GB FACT de VRAM, hasta 128 GB FACT unificados o un modelo menor? Justifica capacidad, contexto y latencia.
Modelos que combina: presupuesto de memoria de IA + latencia, ancho de banda y localidad de datos.
Escenario 2 — API concurrente
El modelo cabe, pero más concurrencia causa OOM y peor tiempo por token. ¿Reducirías contexto o batch, validarías cuantización de pesos, añadirías réplicas o usarías un modelo menor? Propón dos mediciones que separen capacidad, transferencia y cómputo.
Modelos que combina: memoria de IA + forma del trabajo CPU/GPU + Roofline.
Escenario 3 — Entrenamiento distribuido
El entrenamiento escala dentro del servidor, no entre racks: las GPU esperan sincronización. ¿Comprarías GPU, reparticionarías o mejorarías red? Explica tráfico y validación.
Modelos que combina: comunicación (latencia y ancho de banda, incluido all-reduce) + medición extremo a extremo + escalar amplifica movimiento y energía.
Flashcards
Estas flashcards son recuperación después de clase; no añaden minutos al bloque presencial.
- ISA: contrato de instrucciones y estado visible que una CPU implementa.
- Microarquitectura: organización interna que cumple una ISA y cambia el rendimiento.
- Latencia: tiempo para terminar una unidad de trabajo.
- Throughput: unidades terminadas por intervalo.
- Ancho de banda: bytes transferidos por intervalo.
- Localidad: reutilizar datos cerca del cómputo para evitar viajes.
- Forma CPU: pocos flujos flexibles, control irregular y baja latencia.
- Forma GPU: muchos flujos regulares para elevar throughput.
- Intensidad aritmética: FLOP realizados por byte movido.
- Roofline: mínimo entre techo de cómputo y ancho de banda por intensidad.
- Potencia: tasa instantánea de uso de energía, expresada en W.
- Energía: potencia integrada durante tiempo, expresada en Wh.
- Memoria de IA: pesos más KV o activaciones, gradientes, optimizador y temporales.
- All-reduce: colectiva que combina y redistribuye valores, como gradientes.
- Medición extremo a extremo: capacidad, latencia, throughput, bytes, potencia y calidad bajo el mismo escenario.
Fuentes
- Hugging Face Transformers — GPU memory usage: pesos mixed precision, gradientes, estados Adam, activaciones y temporales.
- NVIDIA NIM — Troubleshooting GPU Memory OOM: fórmula de pesos, KV cache, contexto y overhead de inferencia.
- NVIDIA Megatron Bridge — Parallelisms Guide: paralelismo de datos/modelo y comunicación colectiva.
- Apple Newsroom — MacBook Pro con M5 Pro y M5 Max: memoria unificada y bandwidth del M5 Max.
- NVIDIA — GeForce RTX 5090: capacidad y TGP; arquitectura RTX Blackwell: bandwidth.
- Google Cloud — TPU7x Ironwood: HBM, picos por precisión, interconexión y tamaño de pod.
- NVIDIA — DGX GB300: composición, memoria y bandwidth; NVL72 System Components: NVLink, refrigeración y potencia máxima.